OCR - это вход, не результат
Распознать текст из документа уже недостаточно. В реальном процессе нужно понять тип документа, выделить поля, сопоставить их со справочниками, проверить правила и показать человеку, где система не уверена.
Поэтому Document AI проектируем как конвейер: приём документа, OCR, извлечение полей, проверка полей, проверка и выгрузка. Если какого-то слоя нет, он всё равно появится. Только уже в виде ручной боли оператора.
Правила спасают от красивой ошибки
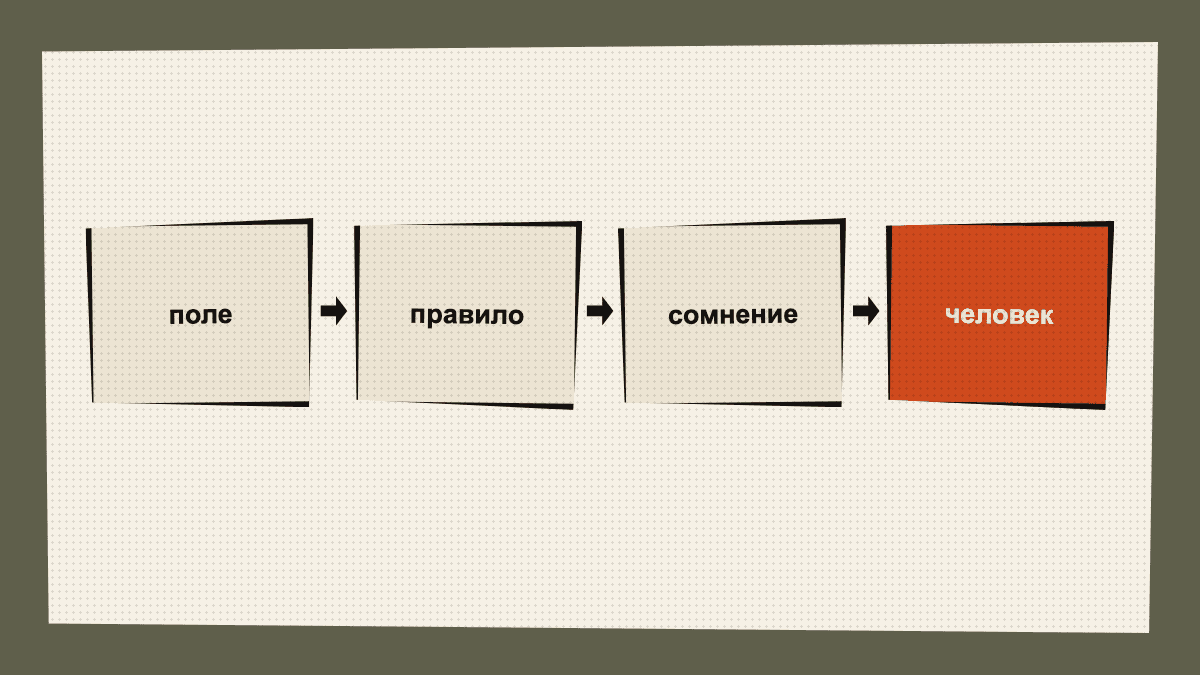
Правила могут быть простыми: сумма строк равна итогу, ИНН существует, дата не в будущем, номер договора есть в базе. Именно эти простые проверки делают систему полезной, потому что уменьшают ручные перепроверки и дают оператору список спорных мест.
- структурные проверки: обязательные поля, формат, тип документа
- арифметика: суммы, НДС, количество, итог
- сверка: контрагент, договор, номенклатура, лимиты
Как выглядит нормальная пробная версия
Для пробной версии обычно хватает 20-50 документов разных типов и качества. Результат должен быть не только в JSON или Excel, но и в интерфейсе проверки: поле, значение, уверенность модели, исходный фрагмент, ошибка правила и кнопка подтверждения.
Так быстро видно, где система уже экономит время, а где нужен другой OCR, дообучение, нормализация справочников или изменение шаблонов документов. Да, иногда проблема не в ИИ. Такое тоже бывает.
Хотите проверить это на своих данных? Разберём задачу бесплатно и скажем, стоит ли браться.
Извлечение полей: модель должна объяснять, откуда взяла значение
В Document AI доверие появляется не от высокого уверенность модели на карточке, а от возможности проверить источник. Если система извлекла сумму, дату, ИНН, артикул или номер договора, оператор должен видеть фрагмент документа, страницу и правило, по которому поле принято или отправлено на проверку.
Поэтому интерфейс проверки важен не меньше модели. Он показывает исходный документ, найденные поля, подсветку фрагментов, список нарушенных правил и историю правок. Без такого интерфейса ИИ просто перекладывает работу: раньше оператор искал поле глазами, теперь он перепроверяет непонятный ответ модели.
Очередь ручной проверки: где человек действительно нужен
Не все документы должны попадать человеку. Простые случаи можно принимать автоматически, если все обязательные поля найдены, уверенность модели выше порога, арифметика сходится, контрагент есть в справочнике и нет конфликтов правил. Всё остальное должно попадать в очередь проверка с понятной причиной.
Причина важнее статуса. «Нужна проверка» бесполезно. Лучше: «сумма строк не равна итогу», «контрагент не найден», «дата договора позже даты счёта», «поле найдено в двух местах», «OCR не уверен в цифре». Тогда оператор не расследует всё заново, а проверяет конкретный риск.
- автоматически: все правила пройдены и поле подтверждено источником
- проверка: есть конфликт, низкая уверенность или неизвестный справочник
- отказ: документ не подходит под процесс или нарушает стоп-условия
Как собрать контрольный набор для документов
Golden set - это небольшой набор документов с ручной разметкой правильных полей. Он нужен, чтобы сравнивать версии OCR, промптов, извлечение полей-модели и правил. Без контрольный набор команда будет спорить по ощущениям: «вроде стало лучше» против «кажется, стало хуже».
Для первого набора берут 30-100 документов: типовые, редкие, плохие сканы, разные поставщики, старые шаблоны, документы с исправлениями и документы, которые должны уйти в отказ. Для каждого поля фиксируют значение, тип ошибки, страницу и допустимость автопринятия.
Интеграция: экспортируйте решение, а не сырой ответ
В 1C, ERP, CRM или Excel должен уходить не «текст, который сказала модель», а структурированное решение: тип документа, поля, статус, причины проверка, ссылка на исходник, версия правила и кто подтвердил результат. Это позволяет аудитору или бухгалтеру восстановить путь документа.
Если интеграция принимает только финальные значения, оставьте отдельный журнал качества. Он пригодится, когда нужно понять, почему поле было принято, кто его исправил и какие типы документов чаще всего тормозят процесс.
- поле + значение + источник + уверенность модели
- статус автоматически/проверка/отказ и причина
- история правок оператора и версия правил
Где Document AI часто окупается первым
Первый полезный сценарий обычно не самый сложный. Это может быть классификация входящих документов, проверка комплектности, извлечение 5-10 ключевых полей, сверка с договором или подготовка черновика карточки в системе. Такой сценарий проще внедрить и легче измерить.
Сложные процессы лучше добавлять после того, как появился рабочий контур: документы поступают в очередь, поля извлекаются, человек видит спорные места, экспорт работает, ошибки собираются в аналитику. Тогда расширение на новые типы документов становится инженерным развитием, а не новым экспериментом с нуля.
Что сделать дальше
- Разделите распознавание, извлечение сущностей и бизнес-проверку.
- Показывайте оператору уверенность модели и исходный фрагмент документа.
- Экспортируйте только проверенный результат. Сырой текст модели пусть остаётся в лаборатории.
Вывод
Резюме: Document AI приносит пользу не там, где распознаёт больше текста, а там, где превращает документ в проверенный бизнес-объект с понятной ответственностью человека.