Почему OCR недостаточно
Бизнесу нужны поля, уверенность и проверка.
OCR отвечает на вопрос: какой текст есть на изображении. Document AI отвечает на другой вопрос: какие значения нужны бизнес-процессу, можно ли им доверять и что делать, если уверенность низкая. Для первички это критично: ошибка в ИНН, сумме, дате или номере документа может стоить больше, чем ручная обработка.
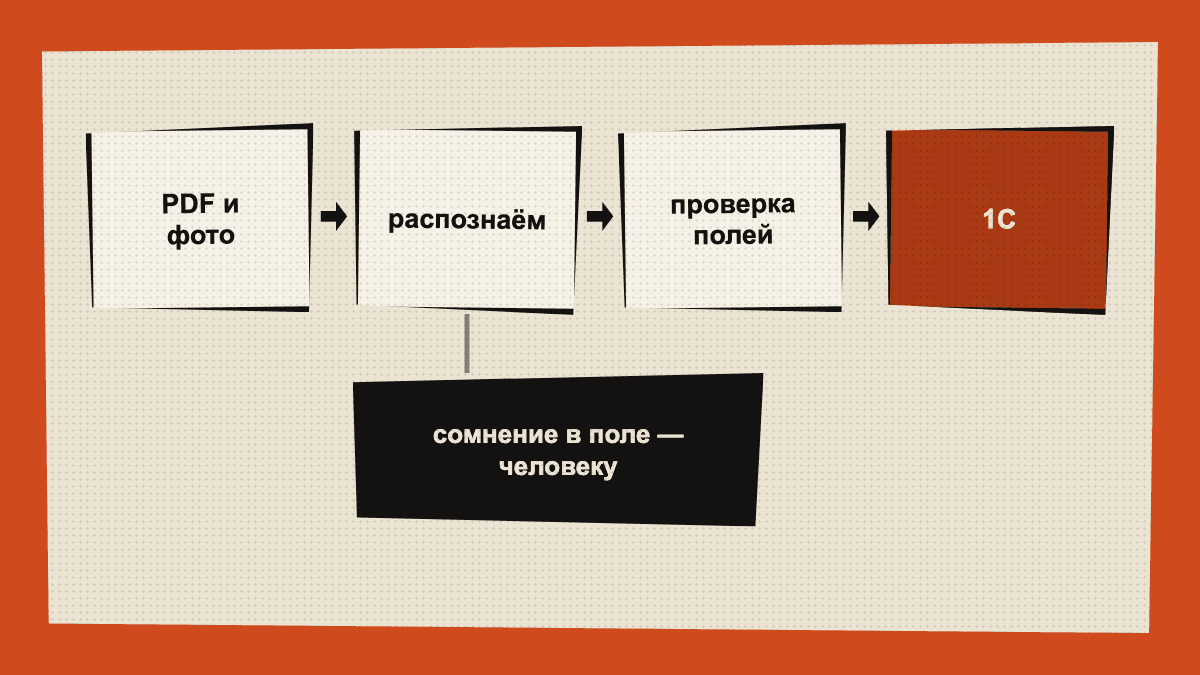
Поэтому хороший пайплайн состоит из нескольких шагов: распознавание, классификация типа документа, извлечение полей, проверка по правилам, сверка со справочниками, очередь ручной проверки и только потом экспорт в 1C или другую систему.
Какие документы брать в первая пробная версия
Не начинайте со всех документов сразу. Выберите один тип: счета, акты, УПД, накладные, заявки, договоры или медицинские формы. Внутри одного типа проще собрать примеры, описать поля, понять качество и настроить правила проверки.
Для первой пробной версии достаточно 100-300 реальных документов, если они покрывают разные поставщики, форматы, качество сканов и исключения. Важно включить плохие случаи: кривые сканы, печати поверх текста, таблицы, разные валюты, старые шаблоны, документы с отсутствующими полями.
- один тип документа
- реальные файлы из почты, архива или ЭДО
- плохие и нестандартные примеры отдельно
Как проверять качество
Общая точность OCR мало что говорит о пользе. Нужно смотреть точность по каждому полю: контрагент, ИНН, КПП, дата, номер, сумма, НДС, позиции, единицы измерения, реквизиты. Поле может быть критичным, вспомогательным или необязательным. Ошибка в одном поле может блокировать весь документ.
Кроме точности нужна уверенность и причина ручной проверки. Например: низкая уверенность модели, сумма не сходится с НДС, поставщик не найден в справочнике, дата вне периода, документ дублирует уже загруженный, реквизиты не совпадают. Такие правила превращают модель в управляемый процесс.
Хотите проверить это на своих данных? Разберём задачу бесплатно и скажем, стоит ли браться.
Интеграция с 1C и учётной системой
Экспорт в 1C лучше делать не сырым результатом модели, а структурированным объектом после проверок. В нём должны быть поля, уверенность модели, источник, статус проверки, ссылка на оригинал, история правок и признак, кто подтвердил документ. Это упрощает аудит и разбор ошибок.
На пробной версии можно начать с режима черновика: система готовит карточку, сотрудник проверяет и отправляет в 1C. После накопления статистики часть документов можно проводить автоматически, оставляя ручную проверку только для низкой уверенности и критичных исключений.
- Черновик перед автоматической записью
- ссылка на оригинал и журнал правок
- правила дублей, справочников и критичных полей
Где появляется окупаемость
Document AI окупается, когда поток документов достаточно большой, ручной ввод дорогой, ошибки болезненны, а данные нужны быстро. Это может быть бухгалтерия, закупки, логистика, страхование, медицина, финансы, маркетплейсы и любые процессы, где сотрудники перепечатывают информацию из файлов.
Эффект считается не только в минутах ввода. Важны скорость обработки, снижение очереди, меньше дублей, прозрачность ошибок, ускорение закрытия периода и возможность видеть статус каждого документа. Поэтому пробная версия должна измерять весь процесс, а не только распознавание.
Что сделать дальше
- Измеряйте точность по полям, а не общую OCR-точность страницы.
- Держите очередь ручной проверки для низкой уверенности и критичных расхождений.
- Экспортируйте в 1C только проверенные и структурированные данные.
Вывод
Document AI для первички должен быть не «OCR с красивым интерфейсом», а проверяемым конвейером: извлечение полей, уверенность модели, правила, ручная очередь и безопасный экспорт в учётную систему.
Вопросы по теме
Сколько документов нужно для пробной версии Document AI?
Для первой пробной версии часто достаточно 100-300 реальных документов одного типа, если они включают разные форматы и плохие случаи.
Можно ли сразу отправлять распознанные данные в 1C?
Лучше начать с черновиков и ручного подтверждения. Автоматическую запись стоит включать после проверки качества, правил и очереди исключений.
Что важнее: OCR-точность или точность полей?
Для бизнеса важнее точность критичных полей и правила проверки. Высокая OCR-точность страницы не гарантирует правильную сумму, ИНН или дату.