Демка врёт слишком убедительно
Пробная версия должен отвечать на вопрос: можно ли доверить системе часть процесса.
RAG отлично выглядит на презентации, когда модель отвечает на один вопрос, который ей фактически подложили под нос. В проде интереснее другое: нашла ли система правильный источник, не потеряла ли исключение, показала ли цитату и поняла ли момент, когда лучше отдать задачу человеку.
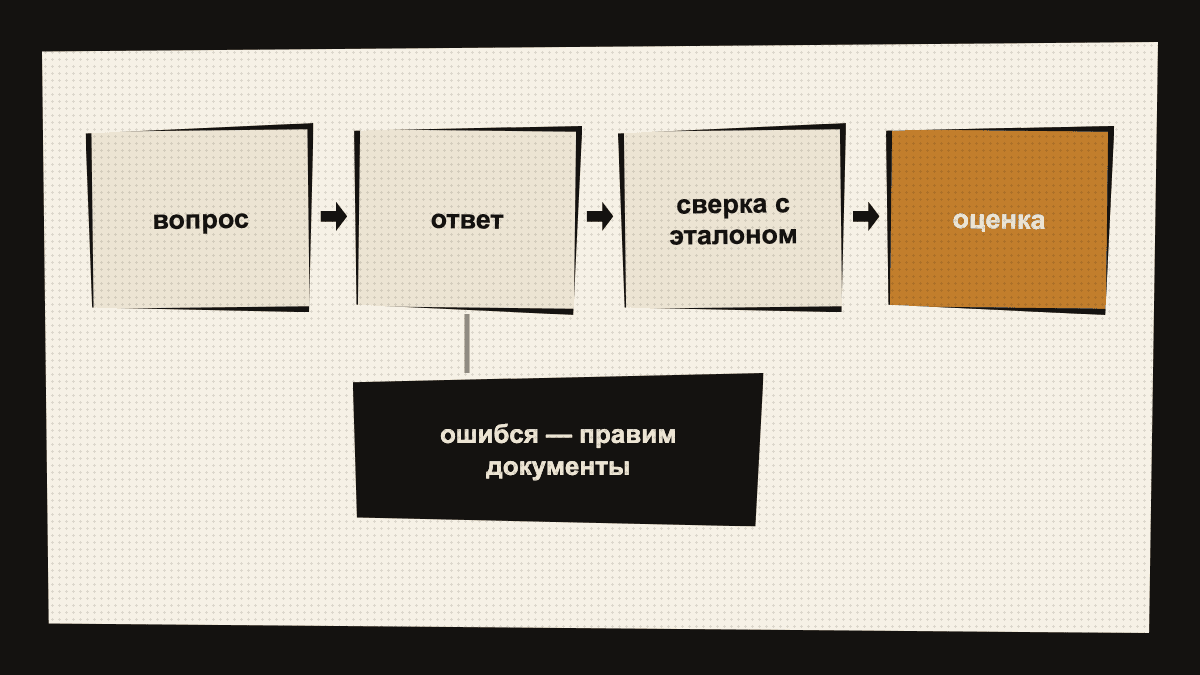
Поэтому оценку надо делать как маленький стенд качества. На входе - реальные вопросы, документы и ожидаемое поведение. На выходе - таблица с ошибками, причинами и решением: чинить базу знаний, менять чанкинг, добавлять повторная сортировка найденного, запрещать тип ответа или выкидывать сценарий из пробной версии.
Что мерить на самом деле
В техническом слое смотрим скучные, но полезные вещи: попал ли нужный документ в число найденных фрагментов, насколько контекст релевантен, нет ли мусора в найденных фрагментах. В ответе - опора на источники, соответствие ответа источникам, полноту и нормальный отказ, когда отвечать нельзя.
В бизнес-слое важнее время первого ответа, доля уверенных ответов, эскалации, правки оператора и стоимость обработки. Эта связка нужна, чтобы не обещать магию, а показывать проверяемый результат.
- поиск по документам: точность найденных фрагментов, полнота найденных фрагментов, доля попаданий
- answer: соответствие ответа источникам, фактическая точность, качество отказов
- process: время обработки, escalation share, operator edits
Минимальный контрольный набор вопросов
Для первой проверки достаточно 30-80 вопросов. Нужны обычные вопросы, редкие исключения, кривые формулировки, вопросы с несколькими источниками и вопросы, на которые система обязана сказать: «не знаю».
Каждый вопрос храните вместе с эталонными источниками, допустимым ответом, запретами и признаком критичности. Тогда вы видите не среднюю температуру по больнице, а конкретное место, где всё развалилось.
Хотите проверить это на своих данных? Разберём задачу бесплатно и скажем, стоит ли браться.
Как собрать вопросы без самообмана
Самая частая ошибка - тестировать RAG на вопросах, которые придумала команда внедрения. Такие вопросы обычно аккуратные, грамматически правильные и слишком похожи на структуру документации. В реальности пользователь пишет иначе: с пропущенными деталями, внутренним жаргоном, старым названием продукта, опечаткой или ссылкой на ситуацию, которую знает только отдел поддержки.
Лучший источник контрольный набор вопросов - архив обращений, поисковые запросы по базе знаний, тикеты, письма менеджерам и вопросы новых сотрудников. Их удобно разложить на четыре группы: частые вопросы, дорогие ошибки, редкие исключения и вопросы без ответа. Последняя группа особенно важна: если система не умеет отказываться, она будет уверенно придумывать ответ там, где оператор должен уточнить данные.
- частые вопросы показывают базовую экономию времени
- дорогие ошибки показывают риск неправильной автоматизации
- вопросы без ответа проверяют отказ и эскалацию
Оценка поиск по документам: ищем не текст, а нужный фрагмент
У RAG две большие зоны ошибки: система может не найти правильный источник или найти источник, но собрать из него плохой ответ. Поэтому поиск по документам нужно проверять отдельно от генерации. Если нужный документ не попал в число найденных фрагментов, дальнейшая модель уже играет в угадайку. Если попал, но рядом лежит много мусорных фрагментов, ответ будет нестабильным и чувствительным к формулировке вопроса.
Практически это выглядит так: для каждого вопроса указываем один или несколько эталонных источников, затем смотрим доля попаданий, место источника в выдаче, точность найденных фрагментов и полнота найденных фрагментов. В бизнесовой версии этого же отчёта можно писать проще: «источник найден», «источник найден, но ниже пятого места», «источник не найден», «найден конфликтующий документ». Такой отчёт понятен не только ML-инженеру, но и владельцу базы знаний.
- доля попаданий: нужный источник вообще попал в выдачу
- место источника в выдаче: насколько высоко источник оказался в списке
- conflict rate: сколько ответов ломают устаревшие документы
Оценка ответа: цитаты, полнота и нормальный отказ
Ответ нельзя оценивать только по приятности текста. Хороший RAG-ответ должен быть привязан к источнику, не добавлять фактов сверх документов, покрывать важные условия и честно говорить, если данных недостаточно. Иногда лучший ответ системы - не длинное объяснение, а короткое «по этим документам ответить нельзя, нужен оператор».
Для ручной проверки удобно использовать шкалу 0-2 по нескольким критериям. опора на источники: всё ли подтверждается источником. полнота: закрыты ли все условия вопроса. полезность ответа: понятно ли, что делать дальше. качество отказов: корректно ли система отказалась, если ответа нет. Через 50-80 вопросов уже видно, какие ошибки системные: плохие документы, неправильный деление документов на фрагменты, слабый повторная сортировка найденного или слишком смелый промпт.
Как считать деньги, а не только метрики
Технические метрики нужны, но решение о внедрении обычно принимают не по точность найденных фрагментов. Руководителю важно понять, сколько времени экономится, какая доля обращений закрывается без поиска вручную, сколько ответов всё равно требует оператора и насколько часто система создаёт риск неправильной консультации.
На пробной версии удобно считать три слоя экономики. Первый: время оператора до и после ИИ-черновика. Второй: доля обращений, где ответ можно отправить без существенной правки. Третий: стоимость ошибки или эскалации. Если система ускоряет частые вопросы, но проваливает редкие критичные исключения, её можно запускать в ограниченном режиме: только на низкорисковые темы, с обязательным источником и ручным подтверждением.
- минуты на обращение до и после RAG
- доля ответов без существенной правки оператора
- темы, где запуск разрешён только с ручным контролем
Что делать после первой проверки качества
После первого прогона не нужно сразу менять модель. Чаще всего самые дешёвые улучшения лежат ближе к данным: убрать устаревшие документы, добавить владельцев и версии, поправить заголовки, разделить длинные регламенты, добавить синонимы и объяснить системе, когда нужен отказ.
Хороший итог пробной версии - список задач улучшений с приоритетами. Например: сначала чистим базу знаний и метаданные, затем меняем деление документов на фрагменты, потом добавляем hybrid search, затем повторная сортировка найденного, и только после этого сравниваем модели. Так вы улучшаете систему последовательно и понимаете, что именно дало прирост качества.
Что сделать дальше
- Соберите 30-80 реальных вопросов. Синтетический FAQ оставьте для презентаций.
- Разделите ошибки на поиск, контекст, генерацию и бизнес-правила.
- Сразу фиксируйте, где нужен оператор и какие ответы должны быть запрещены.
Вывод
Резюме: хорошая пробная версия по базе знаний - это не красивый чат, а измеримый контур поиска, генерации и ручного контроля. Чем раньше появляется контрольный набор вопросов, тем быстрее понятно, где ИИ правда экономит время.