Анализ технической документации: Техдокумент размечается по разделам

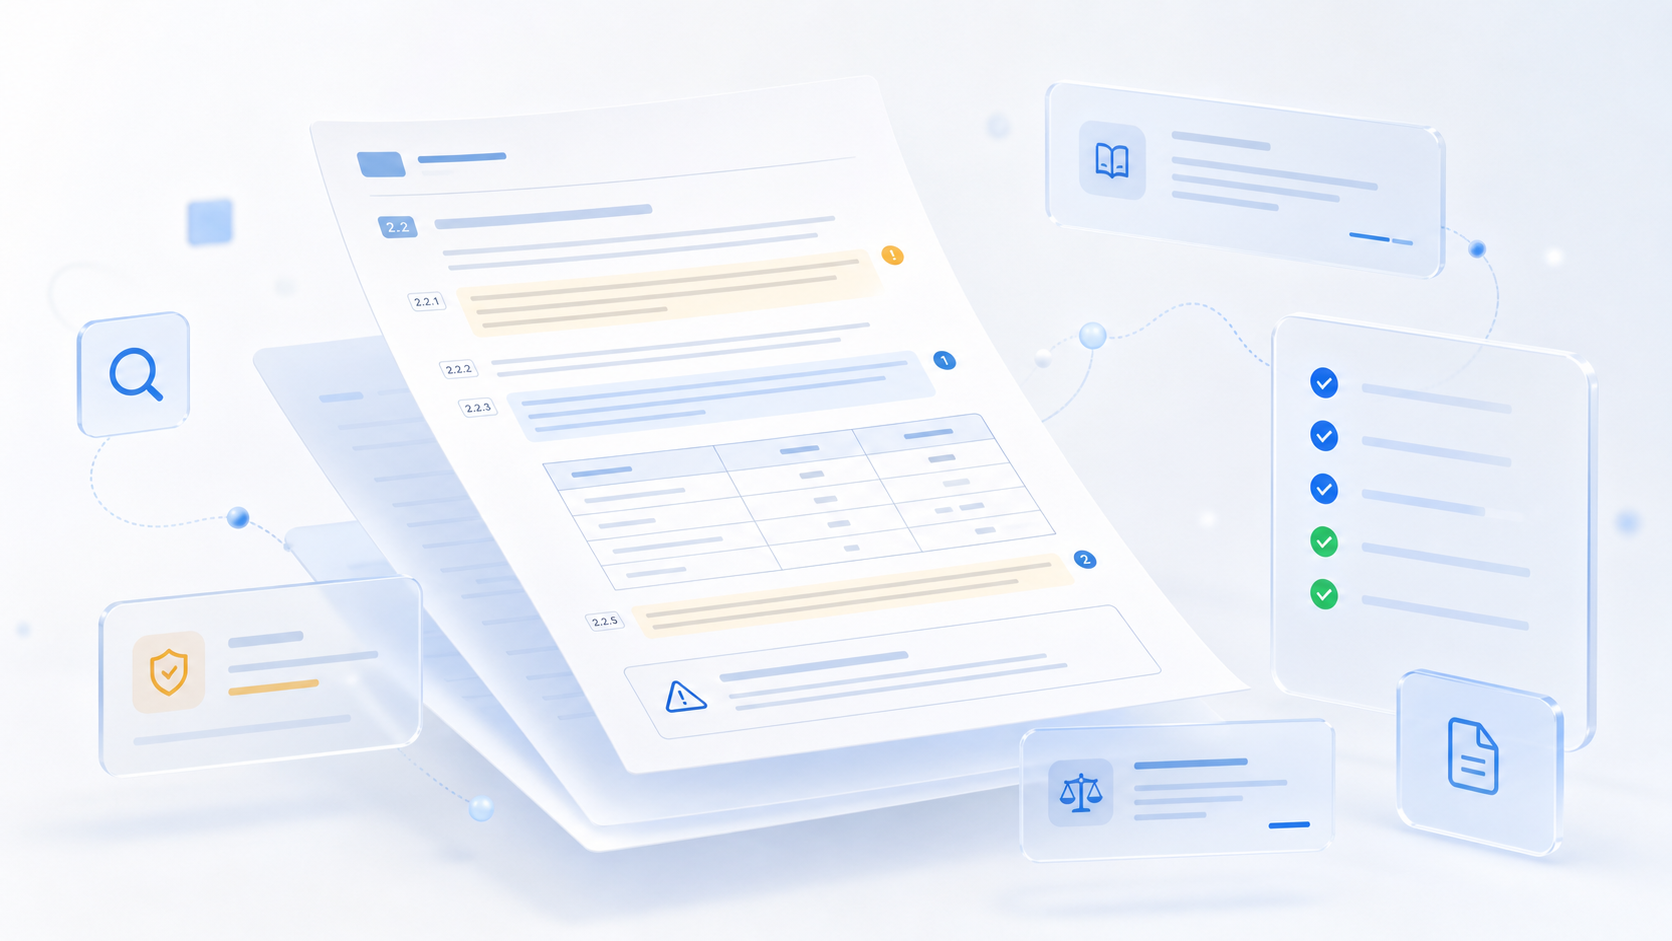
Система разбирает структуру документа, находит нужные нормы и собирает карточки замечаний со ссылкой на источник.

95%точность разметки разделов

Эксперимент · соревнование

Документ читали целиком

Эксперт вручную искал нужные разделы и сверял их с нормами. На объёмных документах проверка занимала дни.

Как это работает по шагам

Это не «чат с PDF», а рабочее место для инженерной проверки. Система разбирает документ на разделы, таблицы и требования, подбирает подходящие нормы из базы стандартов, показывает, насколько уверена.

  1. Система не читает документ сплошным текстом. Она строит карту разделов, таблиц, предупреждений и приложений, чтобы экспеА · видим структуру документа
  2. Для каждого требования поднимаются применимые ГОСТ, СП, ПУЭ или внутренние регламенты. Эксперт видит не просто ответ, а Б · находим применимые нормы
  3. Замечание оформляется как рабочая карточка: что не так, на какую норму опираемся, насколько уверена система и какое дейсВ · проверяем замечания

Замечания со ссылками

2 дня → 2 часа
анализ документа

Каждое замечание можно проверить: видно раздел документа и норму, на которую опирается система.

ИИ для инженеров и экспертов: быстро находит требования в технических документах, сверяет их с нормами и готовит замечан
Все проекты
Тип работы
Эксперимент
Заказчик
Терралинк Code-Fest
Отрасль
Документы
Срок
3 дня разработки
Команда
2 NLP-инженера, 1 DevOps
Стек
Document AI, RAG, Layout Parsing, LLM, FastAPI
Подробно для технических специалистовКак система превращает документ в проверяемые замечания

Задача анализа технической документации не сводится к пересказу PDF. Рабочее решение должно сохранить структуру документа, найти проверяемые требования, связать их с актуальными нормами и оставить эксперту понятный след принятия решения: что проверено, на чём основан вывод и где нужен человек.

Сначала документ переводится в структурированное представление. Для каждой страницы сохраняются текст, координаты блоков, тип объекта и связь с разделом. Это нужно, чтобы система могла не просто ответить на вопрос, а вернуться к точному месту в документе и показать эксперту, где найдено требование.

D={bj}j=1m,bj=(tj, pj, rj, τj)D = \{b_j\}_{j=1}^{m},\quad b_j=(t_j,\ p_j,\ r_j,\ \tau_j)
Каждый блок хранит текст, страницу, координаты на странице и тип: пункт, таблица, предупреждение или приложение.

В технических PDF особенно важны таблицы, предупреждения и приложения. Если потерять структуру, модель может правильно понять общий смысл, но ошибиться в конкретной норме, параметре или единице измерения.

После разметки система ищет релевантные нормы. Запросом становится не весь документ, а конкретный фрагмент с контекстом раздела. Поиск учитывает смысловую близость, тип нормы, дату версии и метаданные проекта. Так эксперт видит не случайные похожие документы, а короткий список источников, которые действительно можно применить к этому требованию.

s(bj,nk)=αcos⁡(ej,ek)+βM(bj,nk)+γV(nk)s(b_j,n_k)=\alpha\cos(e_j,e_k)+\beta M(b_j,n_k)+\gamma V(n_k)
Итоговый score объединяет смысловую близость, совпадение метаданных и актуальность версии источника.

Этот слой особенно полезен в компаниях, где одновременно живут ГОСТ, СП, внутренние регламенты, старые версии документов и проектные исключения.

Затем формируется карточка замечания. Модель не должна выдавать один длинный комментарий: она собирает компактный объект, который можно проверить и экспортировать. В нём есть фрагмент документа, применимая норма, тип риска, рекомендация и уверенность. Если источников недостаточно или есть конфликт норм, карточка сразу уходит на ручную проверку.

zj=g(bj, RK(bj), q),zj=(risk, source, action, conf)z_j = g(b_j,\ R_K(b_j),\ q),\quad z_j=(risk,\ source,\ action,\ conf)
Карточка замечания строится из блока документа, top-K источников и правил проверки.

Такой формат делает результат пригодным для процесса: эксперт работает не с «ответом ИИ», а с очередью решений, где каждое замечание можно принять, исправить или отклонить.

Последний слой — маршрутизация. Замечания с высоким покрытием источниками и понятной причиной можно сразу отдавать эксперту как готовые к подтверждению. Спорные случаи остаются в статусе «на проверку», а низкоуверенные выводы не попадают в итоговый отчёт без ручного решения.

route(zj)={confirm,confj≥θ1∧covj≥θ2review,confj<θ1∨conflictj=1reject,covj<θ0route(z_j)=\begin{cases}confirm,& conf_j\ge\theta_1\land cov_j\ge\theta_2\\review,& conf_j<\theta_1\lor conflict_j=1\\reject,& cov_j<\theta_0\end{cases}
Пороговые правила отделяют уверенные замечания от спорных и недоказанных выводов.

Для бизнеса это снижает риск автоматизации: система ускоряет подготовку проверки, но не прячет неопределённость и не подменяет ответственность эксперта.

На выходе получается не чат с документом, а проверяемое рабочее место: структура документа, применимые нормы, карточки замечаний, решения эксперта и отчёт, который можно передать дальше в документооборот или API.

Результаты

Цифры получены на соревновании. Для вашей задачи их проверяем на пробной версии.

  • Заняли 3 место на соревновании Терралинк Code-Fest
  • Достигли 95% точности в разметке разделов, таблиц и проверяемых требований
  • Сократили первичный анализ документа с 2 рабочих дней до 2 часов
  • До 75% рутинной подготовки замечаний можно выполнять до ручной проверки
  • У каждого замечания видно, на чём оно основано: фрагмент, страница, норма, риск и статус
  • Эксперт быстрее принимает решение, а итог можно выгрузить в отчёт, API или систему документооборота
  • Document AI
  • RAG
  • Layout Parsing
  • LLM
  • FastAPI

Хотите похожее решение?

Опишите процесс, данные и желаемый результат — вернёмся с вариантами решения и оценкой первого этапа.