Классификация товарных карточек: Карточка товара находит свою категорию

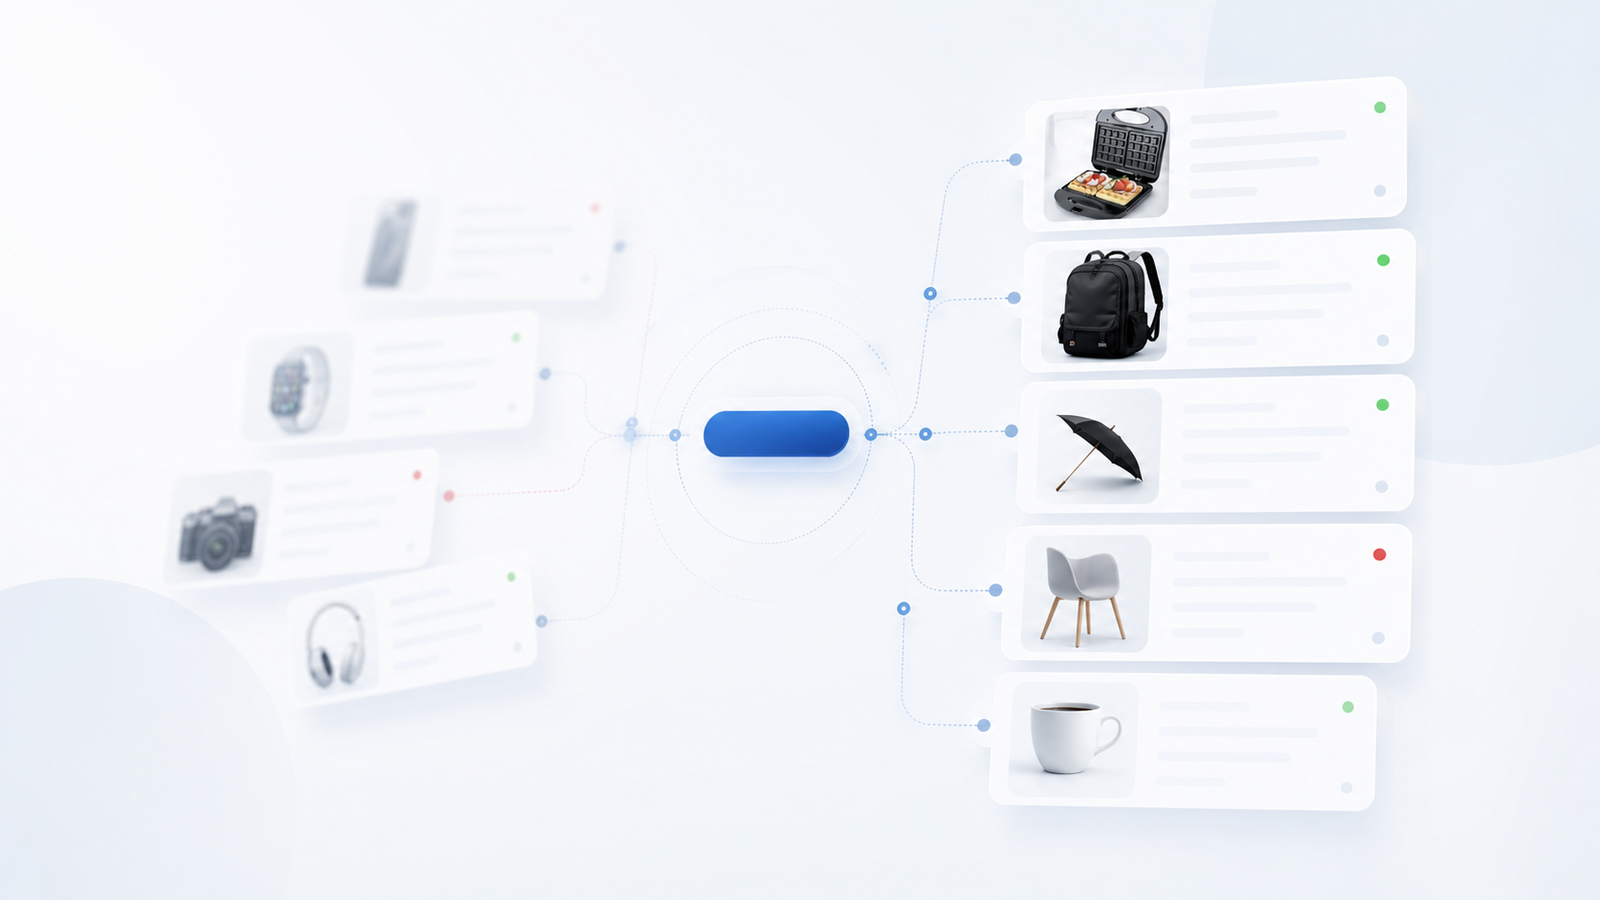
Система собирает карточку целиком — фото и текст, — извлекает признаки товара и сопоставляет их с деревом каталога.

91%точность категории

Эксперимент · соревнование

Модератор раскладывал карточки руками

Категорию выбирали вручную по фото и описанию. На больших потоках это медленно, а ошибки всплывают уже в каталоге.

Как это работает по шагам

Система смотрит на карточку целиком: фотографии, название, описание, категорию, которую выбрал продавец, и заполненные характеристики.

  1. На вход подаём не один текст или одно фото, а всю карточку: изображения, название, описание, артикул, текущую категорию А · собираем карточку целиком
  2. Одна модель определяет, что видно на фото, другая разбирает название и описание, а система выделяет признаки для фильтроБ · извлекаем признаки товара
  3. Модель выбирает не просто тег, а место товара в существующей структуре магазина: категория, подкатегория, раздел и альтеВ · сопоставляем с деревом каталога

Категория и маршрут

82%
можно проверять автоматически

Спорные карточки уходят на проверку человеку, остальные проходят автоматически.

ИИ разбирает каталог: определяет категорию товара, заполняет характеристики и отправляет спорные карточки на проверку
Все проекты
Тип работы
Эксперимент
Заказчик
Ozon E-CUP 2024
Отрасль
Маркетплейсы
Срок
3 недели разработки
Команда
3 ML-инженера, 1 backend разработчик
Стек
Computer Vision, NLP, Multimodal ML, Python, Human-in-the-loop
Подробно для технических специалистовКак формально считается категория и маршрут карточки

Классификация товарных карточек — это не задача «поставить один тег». В рабочем маркетплейсе модель должна учитывать фото, текст, атрибуты, текущую разметку продавца и правила каталога, а затем принять управляемое решение: опубликовать карточку автоматически, предложить оператору короткий список вариантов или отправить её на полноценную проверку.

На первом шаге карточку рассматриваем как единый объект, а не как набор независимых полей. Изображения показывают внешний вид товара, название и описание дают смысловые признаки, атрибуты фиксируют структурированные свойства, а выбранная продавцом категория становится отдельным входным сигналом. Ошибка продавца при этом не выбрасывается: противоречие между фото, текстом и категорией помогает заранее найти рискованные карточки.

xi=(Ii, ti, ai, ciseller)x_i = \left(I_i,\ t_i,\ a_i,\ c_i^{\text{seller}}\right)
Здесь фиксируем изображения товара, нормализованный текст, заполненные характеристики и категорию, выбранную продавцом.

Такой формат входа важен для бизнеса. Система видит не только «что написал продавец», но и то, насколько описание согласуется с фотографией и правилами каталога.

Товарная карточка как единый объект классификации
Одна карточка собирает визуальные, текстовые и структурированные сигналы.

Дальше разные типы данных переводятся в общее пространство признаков. Визуальная модель извлекает признаки из фотографий: тип предмета, форму, цвет, материал и возможные визуальные ограничения. Текстовая модель разбирает название и описание, находит назначение товара, бренд, размерность и синонимы. Атрибутная ветка нормализует табличные поля: размер, пол, материал, сезонность, комплектность.

zi=[fimg(Ii) ; ftext(ti) ; fattr(ai)]z_i = \left[ f_{\text{img}}(I_i)\ ;\ f_{\text{text}}(t_i)\ ;\ f_{\text{attr}}(a_i) \right]
z_i — общий вектор признаков карточки; каждая часть отвечает за свой источник данных.

Именно объединение модальностей делает решение устойчивым. Если в названии написано «кроссовки», но на фотографии виден ботинок или товарный набор, модель получает конфликтный сигнал и может повысить риск ручной проверки.

Слияние визуальных, текстовых и атрибутных признаков
Фото, текст и атрибуты сходятся в один вектор признаков.

После этого карточка сопоставляется с деревом каталога. Модель считает распределение вероятностей по допустимым категориям и выбирает наиболее вероятную ветку. Для интерфейса модератора лучше возвращать не только top-1, но и top-3: оператор не ищет категорию с нуля, а выбирает из короткого списка с объяснимыми альтернативами.

pi(c)=softmax⁡(Wzi+b)c,c^i=arg⁡max⁡c∈Cpi(c)p_i(c)=\operatorname{softmax}(Wz_i+b)_c, \qquad \hat c_i=\arg\max_{c\in\mathcal{C}} p_i(c)
Формула даёт вероятность каждой допустимой категории и выбирает ветку каталога с максимальной уверенностью.

На уровне продукта это превращает классификацию из «магического ответа модели» в проверяемый инструмент: у каждой карточки есть основная категория, запасные варианты и численная уверенность.

Выбор категории в дереве каталога
Модель выбирает ветку каталога и показывает ближайшие альтернативы.

Главная бизнес-логика находится не в нейросети, а в маршрутизации. Карточка проходит автоматически только тогда, когда уверенность достаточно высокая, а риск ошибки ниже допустимого порога. Риск можно считать из нескольких факторов: конфликт фото и текста, близость альтернативных категорий, отсутствие обязательных атрибутов, запрещённые признаки и расхождение с правилами конкретного раздела.

route⁡(xi)={auto,si≥τ ∧ ri≤γreview,otherwise\operatorname{route}(x_i)=\begin{cases}\text{auto}, & s_i\ge\tau \ \land\ r_i\le\gamma \\ \text{review}, & \text{otherwise}\end{cases}
Автопубликация включается только при высокой уверенности модели и риске ниже бизнес-порога.

Пороги не должны быть одинаковыми для всех категорий. В простых разделах можно поднимать долю автоматической обработки, а в дорогих или юридически чувствительных категориях — снижать риск и чаще отправлять карточки оператору.

Маршрутизация карточек между автопубликацией и ручной проверкой
Пороговая логика отделяет безопасную автоматизацию от спорных случаев.

Качество такого решения нельзя оценивать одной метрикой accuracy. В пилоте нужно отдельно смотреть top-1 и top-3 попадание в категорию, полноту обязательных атрибутов, долю карточек, которые прошли без оператора, и цену ошибки на тех карточках, где модель была слишком уверена.

L=CE⁡(yi,pi)+λCE⁡(ai,a^i)+μBCE⁡(mi,m^i)\mathcal{L}=\operatorname{CE}(y_i,p_i)+\lambda\operatorname{CE}(a_i,\hat a_i)+\mu\operatorname{BCE}(m_i,\hat m_i)
Функция потерь соединяет классификацию категории, предсказание атрибутов и решение модерации.

Обучение удобно строить как multi-task: модель одновременно оптимизирует категорию, атрибуты и решение модерации. Тогда она не только выбирает раздел каталога, но и помогает заполнить карточку, найти риск и дать оператору понятную причину проверки.

Контроль качества модели классификации товарных карточек
В пилоте оцениваем не только точность, но и экономику ручной проверки.

На выходе получается не «чёрный ящик», а управляемая очередь решений: понятная категория, обязательные атрибуты, уровень уверенности, альтернативы и причина, почему конкретная карточка прошла автоматически или ушла оператору.

Результаты

Цифры получены на соревновании. Для вашей задачи их проверяем на пробной версии.

  • 91% точность определения категории на тестовой выборке
  • 82% карточек можно обрабатывать без оператора при заданном пороге уверенности
  • Сократили время решения модератора с 5 минут до 30 секунд
  • Каждое решение можно объяснить: на что опиралась система, насколько уверена, какие есть варианты и почему нужна ручная проверка
  • Прототип вошёл в топ-5 Ozon E-CUP 2024
  • Computer Vision
  • NLP
  • Multimodal ML
  • Python
  • Human-in-the-loop

Хотите похожее решение?

Опишите процесс, данные и желаемый результат — вернёмся с вариантами решения и оценкой первого этапа.