
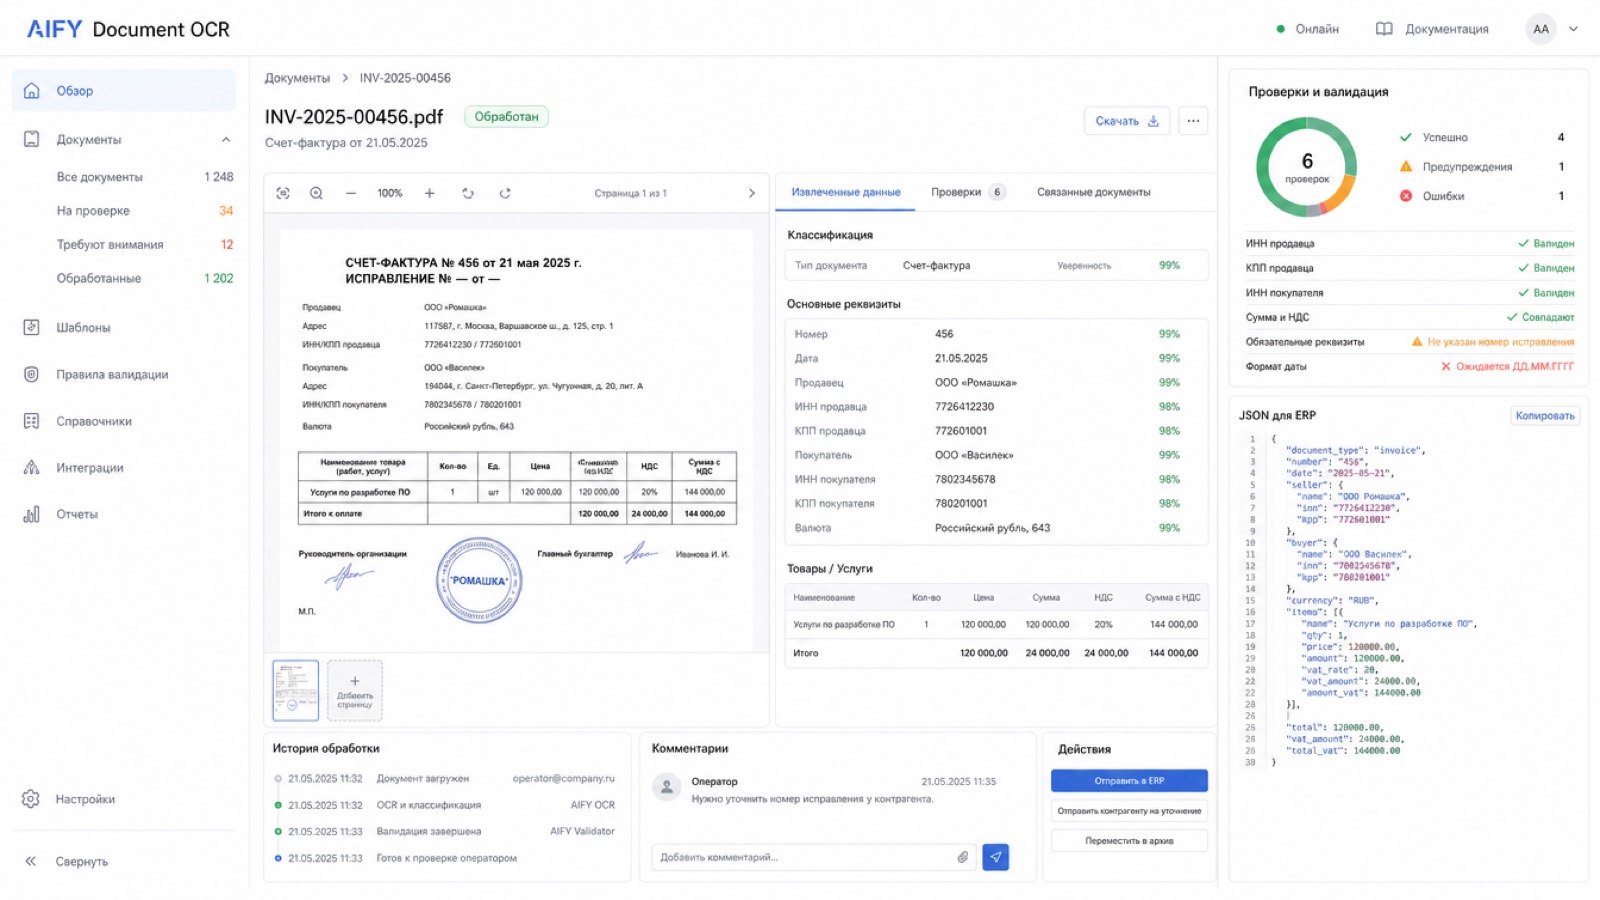
Распознавание первичных документов: Скан превращается в запись для ERP

Система достаёт реквизиты, суммы и позиции, показывает, откуда взято каждое значение, и проверяет правила.

Пример работы · документы

Первичку переносили руками

Бухгалтерия вручную переносила реквизиты и суммы из PDF, а ошибки всплывали при оплате или закрытии периода.

Как это работает по шагам

OCR распознаёт документ, LLM классифицирует тип и поля, валидатор проверяет ИНН, суммы, НДС и обязательные реквизиты, а спорные документы попадают оператору с подсветкой причины.

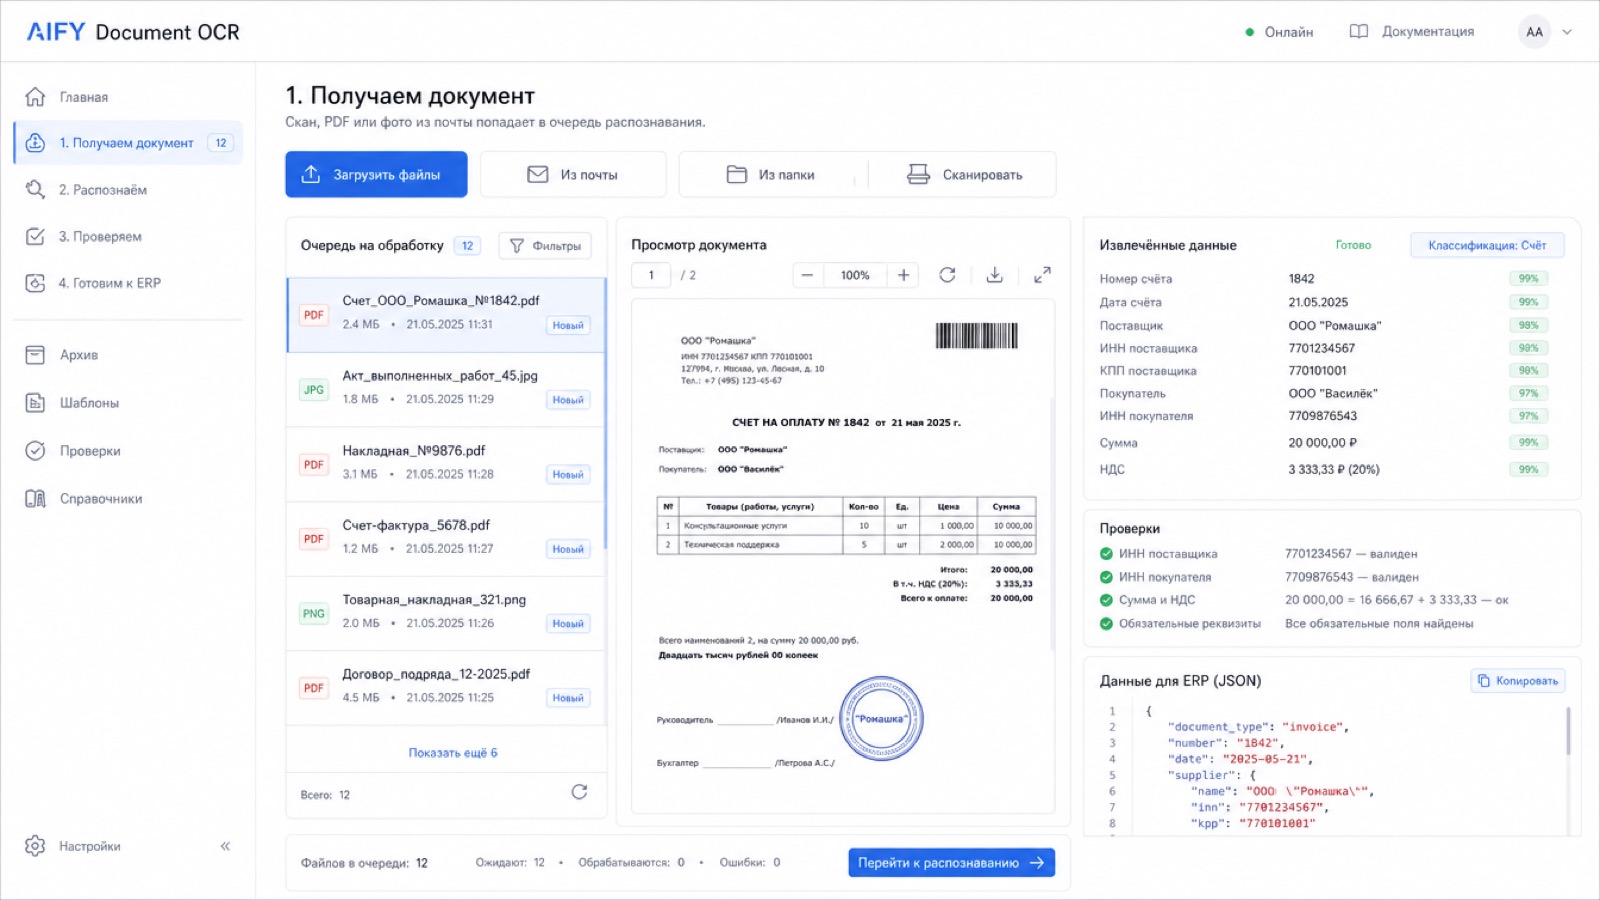
  1. Скан, PDF или фото из почты попадает в очередь распознавания.А · получаем документ
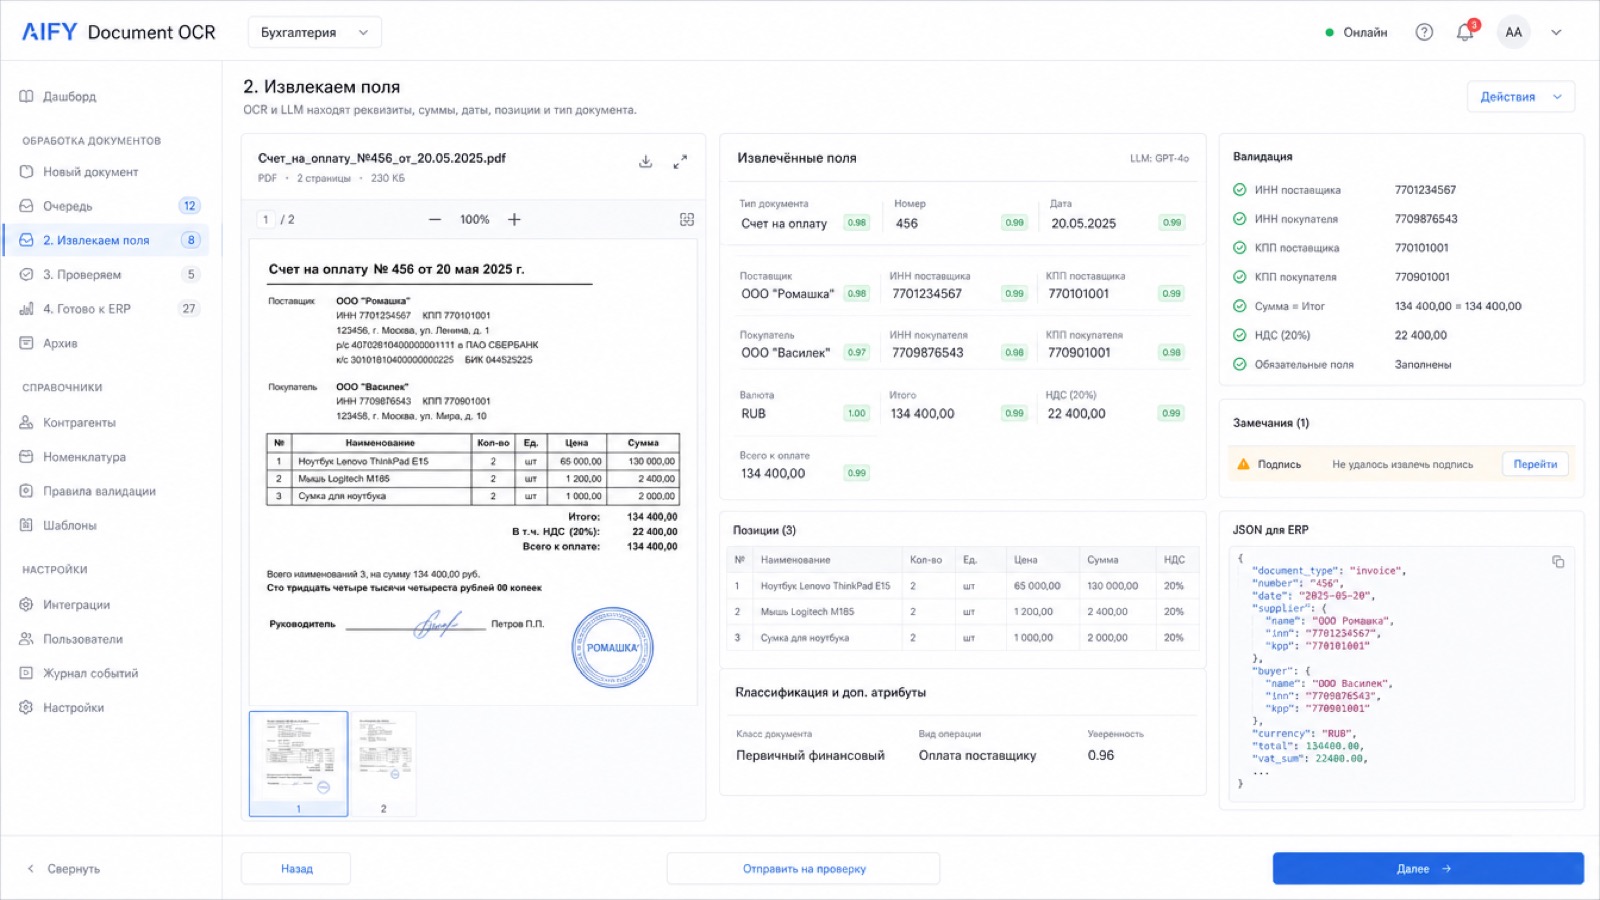
  2. OCR и LLM находят реквизиты, суммы, даты, позиции и тип документа.Б · извлекаем поля
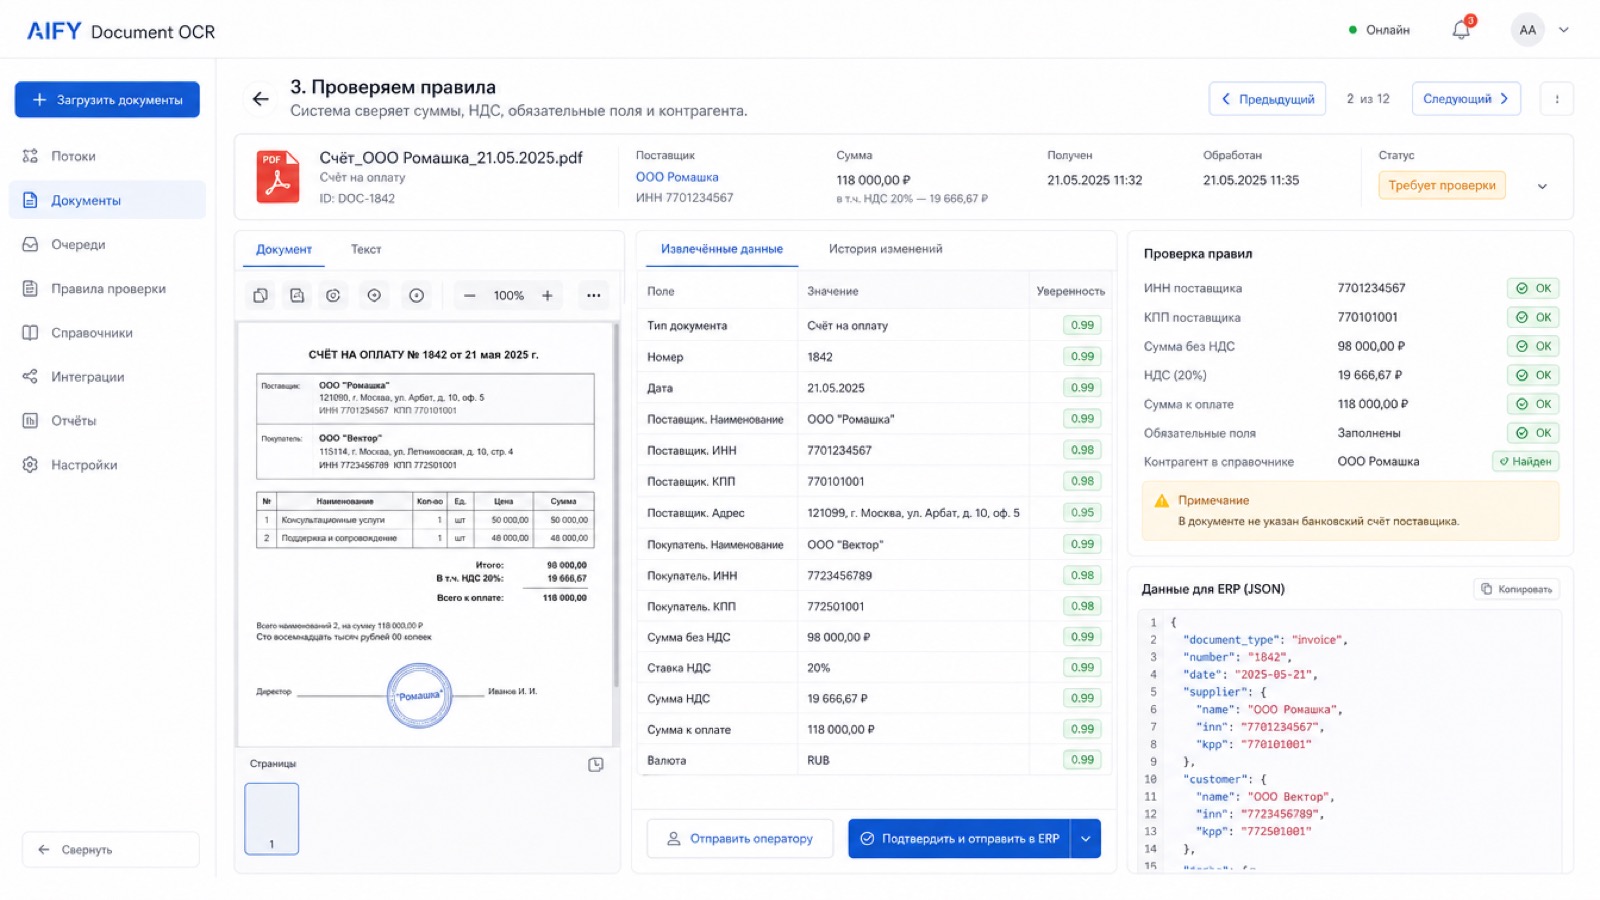
  3. Система сверяет суммы, НДС, обязательные поля и контрагента.В · проверяем правила

Данные для ERP

Спорные документы уходят на проверку, простые проходят автоматически.

ИИ извлекает данные из счетов, актов и накладных, проверяет ошибки и готовит запись для ERP
Все проекты
Тип работы
Пример работы
Заказчик
Пример для бухгалтерии и бэк-офиса
Отрасль
Документооборот
Срок
2-4 недели на пробную версию на реальных документах
Команда
1 ML-инженер, 1 backend разработчик, 1 аналитик
Стек
OCR, Document AI, LLM, FastAPI, 1C/ERP API
Подробно для технических специалистовКак документ превращается в проверяемые данные

Рабочий OCR-контур не заканчивается распознаванием текста. Чтобы первичку можно было проводить в учёте, система должна сохранить координаты источника, извлечь поля, проверить правила и объяснить оператору каждое спорное место.

Первый слой — нормализация входа. Документы приходят как PDF, сканы, фотографии или архивы из почты. Система определяет тип файла, качество изображения, количество страниц, поворот, наличие таблиц и отправляет документ в нужную очередь обработки.

d=(pages, type, source, quality, channel)d=(pages,\ type,\ source,\ quality,\ channel)
Документ хранит страницы, предполагаемый тип, канал поступления и качество входных данных.

Для бизнеса это снимает первую ручную операцию: бухгалтеру не нужно сортировать поток на счета, акты и УПД до того, как документ попал в учётную систему.

После OCR система получает не просто строку текста, а разметку страницы: блоки, строки, таблицы и координаты. Это принципиально важно для проверки: если модель извлекла сумму или ИНН, оператор должен увидеть место на исходном документе.

fi=(namei, valuei, bboxi, pi)f_i=(name_i,\ value_i,\ bbox_i,\ p_i)
Каждое поле хранит название, значение, координаты на документе и уверенность модели.

Так появляется связка «поле — значение — источник», которая делает результат объяснимым и пригодным для ручного контроля.

Дальше включаются бизнес-правила. Для первички важно сверить ИНН, контрагента, дату, НДС, сумму строк и итог. Если правило не проходит, система должна показать не общий статус «ошибка», а конкретную причину и поле, которое нужно проверить.

valid(d)=⋀j=1mrulej(f1,…,fn)valid(d)=\bigwedge_{j=1}^{m} rule_j(f_1,\ldots,f_n)
Документ считается готовым только если все обязательные правила прошли проверку.

Такой слой снижает риск тихой автоматизации: документ либо проходит набор проверок, либо попадает оператору с понятной причиной.

Финальный результат — структурированный объект для учётной системы. Он содержит поля, статус проверки, ошибки, ссылки на исходный документ, журнал действий и формат передачи. Такой объект можно отправить в 1С, ERP, архив или внутренний API без повторного ручного ввода.

payload=(fields, status, errors, source, audit, export)payload=(fields,\ status,\ errors,\ source,\ audit,\ export)
Payload связывает извлечённые поля, статус, ошибки, источник, журнал действий и канал экспорта.

Именно здесь OCR превращается в бизнес-процесс: бухгалтерия получает не распознанный текст, а проверяемые данные, готовые к проведению или точечной ручной правке.

Такой кейс полезен компаниям, где первичные документы идут потоком: система забирает ручной перенос, оставляет человеку только спорные места и сохраняет проверяемость каждого проведённого документа.

Результаты

Цифры получены в примере без заказчика. Для вашей задачи их проверяем на пробной версии.

  • Сокращается ручной перенос реквизитов, сумм, дат и позиций из счетов, актов, накладных и УПД
  • Каждое поле можно проверить: видно значение, уверенность модели и место на исходном документе
  • Ошибки объясняются правилом: расхождение НДС, не найден контрагент, нет обязательного поля или не сходится сумма строк
  • Документы разделяются на автоматическую обработку и ручную проверку по понятным порогам
  • На выходе формируется структурированный объект для 1С, ERP, архива, отчёта или внутреннего API
  • OCR
  • Document AI
  • LLM
  • FastAPI
  • 1C/ERP API

Хотите похожее решение?

Опишите процесс, данные и желаемый результат — вернёмся с вариантами решения и оценкой первого этапа.