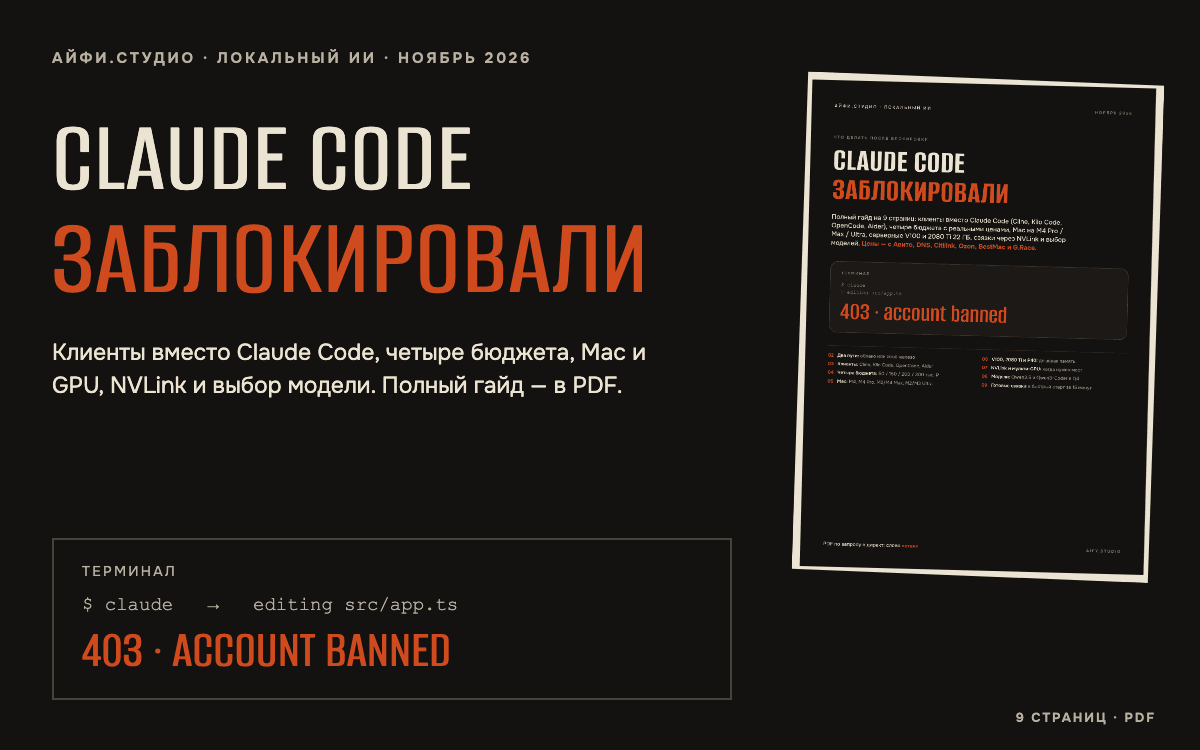
Сначала меняем клиент, а не всю систему
Открытые инструменты читают проект, правят файлы и запускают команды, а модель можно подключить отдельно.
Claude Code сочетает две вещи: агентную оболочку и доступ к модели. Если доступ к аккаунту потерян, оболочку можно заменить независимо от модели. OpenCode, Cline, Kilo Code и Aider подключаются к облачным API и к локальным моделям через Ollama, LM Studio или vLLM.
Для терминала ближе всего OpenCode и Aider: первый удобен для агентных сессий, второй — для аккуратной работы с git. Cline и Kilo Code живут в VS Code. Cline показывает каждую правку как diff перед применением; Kilo Code добавляет режимы Architect, Code и Debug и индексацию репозитория.
- OpenCode — агентные сессии в терминале, работа по SSH и подключение разных API.
- Cline — Plan/Act в VS Code, просмотр diff, запуск терминала и браузера.
- Kilo Code — режимы Architect, Code и Debug, индексация репозитория и работа с локальными моделями.
- Aider — терминал и git-дисциплина: карта репозитория и атомарные изменения.
Облако, своё железо или гибрид
Облачный API — самый короткий путь обратно к работе: не нужно покупать и обслуживать железо, а топовые модели обычно сильнее локальных. За это команда принимает зависимость от доступа, тарифов и правил сервиса, а код и запросы уходят на внешний сервер.
Локальная модель оставляет код и данные внутри контура и не зависит от блокировки внешнего аккаунта. Плата за токены исчезает, но появляются стоимость железа, настройка, шум, нагрев и обслуживание. Для чувствительных модулей разумен гибрид: код и данные остаются локально, а сложные нечувствительные задачи уходят в облако.
- Нужно продолжить работу сегодня — начать с облачного API.
- Код под NDA или персональные данные — рассмотреть локальный контур.
- Общий сервер на команду — посчитать одновременные запросы и очередь, а не только объём памяти.
Сколько памяти нужно агенту
В память должны поместиться не только веса модели, но и контекст репозитория.
Небольшие модели на 7–9B подходят для автодополнения и простых вопросов, но чаще теряют формат вызова инструментов. В агентном цикле это превращается в ошибки JSON, повторные действия и зацикливание. Для таких сценариев лучше выбрать Continue или Twinny, а не ждать от маленькой модели полноценной самостоятельной разработки.
В гайде практический ориентир для агентных правок — Qwen3-Coder 30B-A3B от 24 ГБ памяти. На 24–32 ГБ разумно начинать с 30B, на 48–64 ГБ открываются более крупные 70B и 80B в подходящем квантовании. При этом 4–5 ГБ стоит оставить под KV-кэш: системный промпт, дерево файлов и фрагменты кода быстро занимают десятки тысяч токенов.
- 8–16 ГБ — автодополнение, чат и простые правки одного файла.
- 24–32 ГБ — основной диапазон для Qwen3-Coder 30B-A3B и моделей сопоставимого размера.
- 48–64 ГБ — более крупные модели и больший контекст; точный предел зависит от квантования и движка.
- 128 ГБ — тяжёлые локальные конфигурации и командные сценарии из полной версии гайда.
Хотите проверить это на своих данных? Разберём задачу бесплатно и скажем, стоит ли браться.
Четыре ориентира по бюджету
В PDF приведены таблицы с ценами на 3–4 ноября 2026: Авито, DNS, Citilink, Ozon, BestMac и другие магазины. Это срез объявлений, а не фиксированный прайс. Ниже — только логика выбора; актуальные комплектации и цены проверяйте перед покупкой.
- До 50 000 ₽ — мини-ПК N100 с 16 ГБ или Mac mini M1 16 ГБ б/у: автодополнение и простые скрипты, не полноценный агент.
- Около 150 000 ₽ — Mac mini M4 24 ГБ для 27B впритык или ПК с RTX 4060 Ti 16 ГБ для 9B и небольших правок: это разные пределы по памяти и контексту.
- Около 200 000 ₽ — б/у RTX 3090 24 ГБ и остальная сборка: в гайде получается 160–180 тысяч, агентный Qwen3-Coder 30B-A3B.
- От 300 000 ₽ — Mac Studio M2 Max 64 ГБ б/у, система с 128 ГБ или связка 2×3090: более крупные модели и командный сервер.
Mac, V100 и 2080 Ti: где компромисс
У Apple Silicon единая память доступна и процессору, и графике, поэтому выбор зависит от двух параметров: объёма и пропускной способности. Mac mini M4 Pro 24 ГБ быстрее базового M4, но не снимает ограничение по объёму. Для агентной работы в гайде рекомендуют версию на 48 ГБ; среди б/у вариантов сравнивают её с Mac Studio M2 Max 64 ГБ.
Серверные V100 и модифицированные 2080 Ti 22 ГБ дешевле RTX 3090, но экономия достаётся инженерными рисками. Их стоит рассматривать как сборку для энтузиаста, а не как беспроблемную замену обычному рабочему компьютеру.
- V100: различать SXM и PCIe, заранее решить пассивное охлаждение и учесть старую архитектуру Volta.
- 2080 Ti 22 ГБ: это перепаянная память и модифицированный BIOS, поэтому обязательны стресс-тесты и проверка продавца.
- Любая б/у сборка: проверять VRAM, HotSpot, артефакты, вентиляторы, разъёмы питания и запас блока питания.
Когда нужны две карты и NVLink
Если модель не помещается в одну карту, движок делит её между несколькими GPU. NVLink сам по себе не превращает две карты в одну с общей автоматически доступной памятью: vLLM, llama.cpp или ExLlamaV2 всё равно распределяют слои и данные.
При pipeline parallel карты обрабатывают разные слои по очереди, обмен данными небольшой и часто хватает PCIe. При tensor parallel они считают каждый слой вместе и синхронизируются многократно — здесь быстрый мост полезнее. На практике выбор режима зависит от движка, модели и материнской платы, а не только от наличия разъёма NVLink.
- Проверить шаг PCIe-слотов и совместимость моста до покупки второй карты.
- Заложить охлаждение верхней карты и блок питания с запасом на пиковую нагрузку.
- Сравнивать связку по скорости конкретной модели и движка, а не по сумме гигабайт в спецификации.
С чего начать без лишних трат
Сначала верните рабочий процесс на выбранном клиенте и существующем компьютере. Затем измерьте, что именно не устраивает: качество ответов, скорость, лимит контекста, конфиденциальность или стоимость API. Покупка железа решает только часть этих проблем.
Для локального запуска поставьте Ollama, выберите модель по свободной памяти и подключите её к OpenCode, Cline, Kilo Code или Aider. Первую проверку делайте на одном репозитории с небольшими задачами и обязательным просмотром изменений человеком. Полная версия PDF содержит готовые связки, команды запуска и подробные таблицы.
- Один клиент, одна модель, один тестовый репозиторий.
- Сначала чтение и небольшие diff-правки, затем более широкие права агенту.
- Замерить скорость и качество на своих задачах до заказа нового железа.
Что сделать дальше
- Сначала выбрать клиент и проверить его на одном репозитории, затем решать, где запускать модель — в облаке или локально.
- Оставить минимум 4–5 ГБ свободной памяти под контекст проекта: одного объёма весов модели для стабильной работы мало.
- Перед покупкой б/у GPU проверить память под нагрузкой, температуру, охлаждение, питание и гарантию; цены сверить в день покупки.
Вывод
После блокировки Claude Code не обязательно сразу собирать локальный сервер. Быстрее сначала заменить клиент и подключить доступную модель, а затем по реальным задачам решить, нужны ли своё железо, NVLink и крупные модели. Полные таблицы и срез цен — в PDF наверху страницы.
Вопросы по теме
Что поставить вместо Claude Code?
В терминале — OpenCode или Aider, в VS Code — Cline или Kilo Code. Все четыре варианта работают с внешними API и локальными моделями; выбор зависит от привычного редактора и нужного уровня контроля над изменениями.
Какой компьютер нужен для локального агента?
Для автодополнения достаточно 8–16 ГБ памяти и небольшой модели. Для агентной работы с проектом в гайде рекомендуют начинать с 24 ГБ и Qwen3-Coder 30B-A3B, оставляя запас под контекст. Точная конфигурация зависит от модели, квантования и размера репозитория.
NVLink объединяет память двух видеокарт?
Не автоматически. Движок должен явно распределять модель между картами. NVLink ускоряет обмен данными между GPU, особенно в tensor parallel, но не отменяет требования к совместимости, охлаждению и питанию.
Нужно ли сразу покупать GPU для закрытого кода?
Не обязательно. Сначала проверьте требования к данным и выбранную модель на небольшой задаче. Иногда достаточно гибридной схемы: чувствительный контекст остаётся локально, а нечувствительные запросы обрабатываются в облаке.